De pilotos a producción: diseñando flujos de IA escalables para empresas LATAM
Introduccion
En LATAM muchos proyectos de inteligencia artificial se estancan justo después del piloto: funcionan en entornos controlados pero no llegan a operar a escala en producción. Las causas recurrentes son datos fragmentados, integraciones frágiles, ausencia de roles claros y falta de gobernanza que permita confiar en modelos en tiempo real. Este artículo propone un marco práctico para diseñar flujos de IA escalables, con pasos concretos, criterios de tecnología y un checklist de gobernanza y talento pensado para organizaciones de la región.
Un marco práctico para pasar a producción
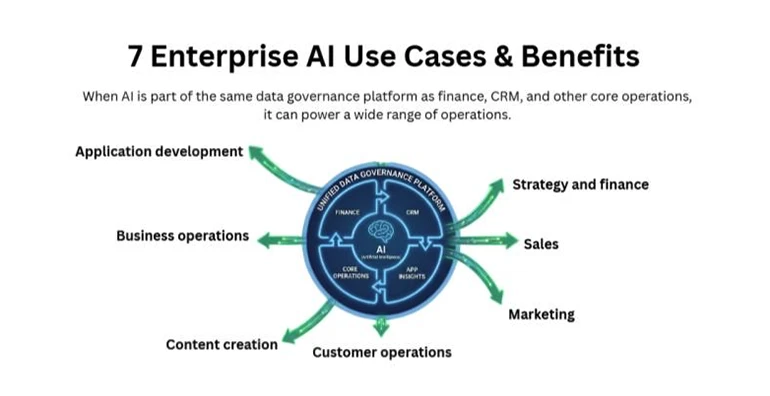
Propongo un marco en cuatro capas que cubre desde la fuente de datos hasta la entrega de valor al cliente:
- Capa de datos (ingesta y calidad)
- Capa de modelos (orquestación y gobernanza)
- Capa de integración (APIs, MLOps y no-code)
- Capa de negocio (KPIs, costos y operación)
Para cada capa, siga estos pasos concretos:
- Identificar fuentes críticas de datos y mapear propietarios.
- Definir esquemas mínimos de calidad (completitud, precisión, latencia).
- Diseñar pipelines reproducibles con control de versiones.
- Implementar un orquestador de modelos con logging y rollback.
- Entregar modelos mediante APIs y flujos no-code para área comercial.
- Medir impacto en métricas de negocio antes y después del despliegue.
Pipelines de datos robustos y orquestación de modelos
Buenas prácticas para pipelines
- Centralice catálogos de datos con linaje mínimo para saber qué alimenta a cada modelo.
- Automatice la limpieza y validaciones en la ingesta; evite transformaciones ad-hoc en notebooks.
- Versione esquemas y snapshots de datos que sirvan para reproducibilidad y auditoría.
Orquestación y despliegue
- Use herramientas de MLOps (orquestadores, CI/CD) para automatizar pruebas y despliegue. Priorice soluciones que permitan retraining programado y validación A/B.
- Mantenga un registro de modelos (model registry) con metadatos: versión, conjunto de entrenamiento, métricas y responsables.
- Defina políticas de rollback y pruebas canary para minimizar riesgo en producción.
Roles no-code y empoderamiento del negocio
Para acelerar adopción sin depender exclusivamente de equipo de datos:
- Introduzca roles no-code/low-code: analistas de negocio que puedan componer pipelines y dashboards sin programar.
- Establezca plantillas reutilizables para casos comunes (scoring, clasificación de texto, recomendaciones).
- Capacite a líderes de línea en interpretación de métricas y en gobernanza básica (sesgos, límites de uso).
Beneficio: reduce el cuello de botella técnico y acorta tiempo desde idea a entrega.
Control de costos y criterios de selección tecnológica
Estrategias para mantener presupuesto bajo control:
- Priorice modelos eficientes en costo (distilaciones, cuantización) para inferencia en tiempo real.
- Seleccione infraestructura híbrida: edge/local para latencias críticas y nube para entrenamiento y tareas batch.
- Defina presupuesto por flujo y monitorice costos por endpoint.
Criterios para elegir herramientas:
- Compatibilidad con su stack de datos (conectores nativos).
- Soporte para versionado y trazabilidad.
- Capacidad de escalado horizontal y políticas de seguridad que cumplan normativas locales.
- Comunidad y soporte en la región (evita herramientas sin presencia o documentación en español si depende de equipos locales).
Métricas de negocio y KPIs esenciales
Mida impacto, no solo accuracy. KPIs recomendados:
- Tasa de adopción interna (usuarios activos del modelo).
- Tiempo de respuesta y latencia en producción.
- Precisión relevante al negocio: lift en ventas, reducción de fraude, tiempo de resolución en soporte.
- Costo por inferencia y retorno de inversión (ROI) trimestral.
Incluya alertas para desviaciones de performance y dashboards para responsables de negocio.
Casos LATAM y lecciones aprendidas
Ejemplos habituales en la región:
- Banca: modelos de scoring integrados con sistemas core, donde la clave fue asegurar latencia y explicabilidad para reguladores.
- Retail: segmentación y recomendaciones con pipelines batch y endpoints cacheados para picos de temporada.
- Salud: validación clínica y manejo de consentimientos que requiere trazabilidad de datos y validaciones legales.
Lección común: proyectos exitosos empatan responsables de negocio con dueños técnicos y acuerdos claros de SLA y datos.
Checklist de gobernanza y talento
- Datos: catálogo, linaje y políticas de retención.
- Modelos: registro, pruebas de robustez y planes de rollback.
- Seguridad: control de accesos, cifrado en tránsito/reposo.
- Compliance: evaluación de impacto y cumplimiento de normativas locales.
- Talento: equipo mixto (ML engineers, SRE, analistas no-code, responsable de producto).
- Operación: SLA definidos, monitoreo de drift y procesos de retraining.
Conclusion
Pasar de pilotos a producción en LATAM exige combinar arquitectura técnica, claridad en roles y gobernanza pragmática. Use el marco de capas descrito para priorizar esfuerzo, mida impacto con KPIs orientados al negocio y controle costos desde el diseño del flujo. Empiece por un caso de negocio con datos disponibles, defina responsabilidades claras y automatice pipelines para garantizar reproducibilidad. Si su organización está lista, el siguiente paso es mapear un proyecto piloto con objetivos de negocio concretos y un plan de 90 días para producción. ¿Quiere un checklist adaptado a su sector? Contáctenos para una sesión breve de diagnóstico.
¿Quieres aplicar esto en tu negocio? Escríbeme y lo vemos juntos.
Hablemos de tu caso