Estrategia híbrida de IA para empresas LATAM: cuándo y cómo mover modelos del cloud al edge
Introduccion
En LATAM, la convergencia entre costos crecientes en la nube, requisitos regulatorios locales y la demanda de respuestas en tiempo real empuja a muchas empresas a considerar arquitecturas híbridas de IA. Migrar modelos del cloud al edge no es solo una decisión técnica: impacta costos operativos, experiencia de usuario, seguridad y cumplimiento normativo. Este artículo ofrece un marco práctico para decidir qué mover al edge, cómo estimar costos y diseñar un roadmap de implementación con checklist y recomendaciones para negociar con proveedores y gestionar el cambio.
¿Por qué adoptar una estrategia híbrida?
Principales motivadores que observamos en empresas de la región:
- Latencia: aplicaciones en retail, manufactura o salud que requieren inferencia en milisegundos.
- Costos de salida/transferencia: transferencia masiva de datos desde dispositivos al cloud se vuelve prohibitiva.
- Regulación y soberanía de datos: leyes locales pueden exigir procesamiento o almacenamiento dentro del país.
- Resiliencia: operar sin conectividad constante mejora disponibilidad en zonas con redes inestables.
- Privacidad: mantener datos sensibles en sitio reduce riesgos de exposición.
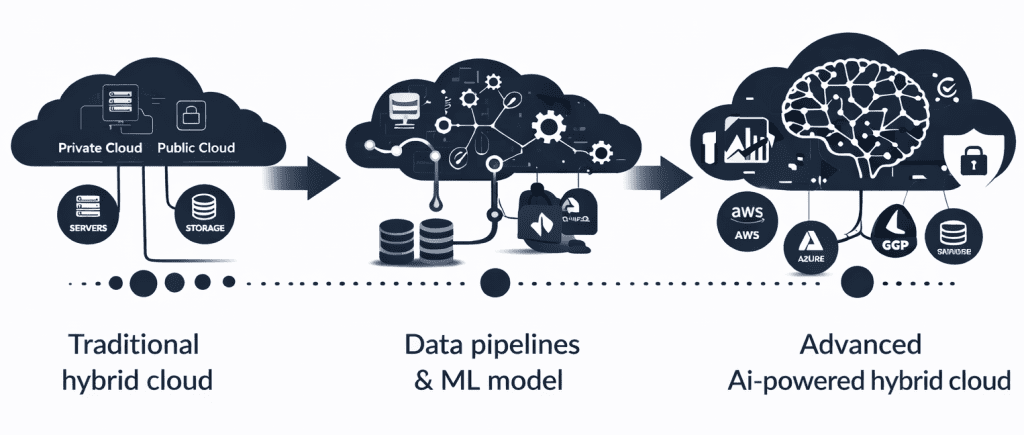
Adoptar un enfoque híbrido permite combinaciones: entrenar y versionar en la nube, desplegar inferencia crítica en edge, y sincronizar resultados resumidos para análisis centralizado.
Decidir qué modelos mover al edge
Un marco rápido para priorizar cargas:
- Identifica casos de uso con requisitos de latencia y privacidad.
- Evalúa la frecuencia de inferencias y el volumen de datos crudos.
- Mide tolerancia a degradación de modelo y necesidad de actualización continua.
- Considera capacidad de hardware y mantenimiento remoto disponible.
Criterios prácticos (lista de verificación):
- Latencia crítica (<100 ms): candidato fuerte para edge.
- Datos sensibles que no pueden salir del país: candidato para edge/local.
- Inferencias de alto volumen que generan altos costos de egress: evaluar edge.
- Modelos grandes que requieren GPUs costosas: mantener en nube si no hay edge especializado.
- Necesidad de centralización/entrenamiento continuo: nube como fuente de verdad.
Recomendación operativa: comenzar por mover modelos de inferencia (no entrenamiento). Descomponer pipelines para enviar solo metadatos o agregados al cloud.
Costos y cumplimiento
Cómo estimar costos al comparar cloud vs edge:
Cost drivers en la nube:
- Uso de GPU/TPU para inferencia.
- Almacenamiento a largo plazo y egress.
- Servicios gestionados (orquestación, monitoring).
Cost drivers en edge:
- Capex en hardware (NVIDIA Jetson, Intel Movidius, TPUs edge).
- Mantenimiento y reemplazo de dispositivos.
- Conectividad local y gestión remota (MLOps en sitio).
- Seguridad física y actualizaciones OTA.
Método rápido de estimación:
- Calcular costo por inferencia en nube (costo por hora del recurso / inferencias por hora).
- Estimar costo total de ownership (TCO) del edge a 3 años (hardware + instalación + ops).
- Comparar punto de equilibrio: ¿cuántas inferencias deben ejecutarse en edge para justificar la inversión?
Cumplimiento:
- Mapear regulaciones locales (protección de datos, regulaciones sectoriales).
- Definir dónde residen datos crudos, procesados y modelos.
- Implementar registro de acceso y cifrado en reposo/transito.
- Plan de auditoría y trazabilidad para demostrar cumplimiento frente a autoridades.
Roadmap, checklist y negociación con proveedores
Roadmap de implementación (fases):
- Diagnóstico (4–6 semanas): inventario de modelos, latencias, volúmenes y requisitos legales.
- Prueba de concepto (6–12 semanas): desplegar 1–2 modelos en un sitio piloto.
- Escalado por oleadas (3–9 meses): estandarizar hardware y pipelines MLOps.
- Operación y mejora continua: monitoreo, retraining y gobernanza.
Checklist para el piloto:
- Objetivos medibles (latencia, costo por inferencia).
- Hardware seleccionado y plan de mantenimiento.
- Estrategia de despliegue (container, ONNX, TF Lite).
- Telemetría y alertas centralizadas.
- Políticas de seguridad y backup.
- Plan de rollback y pruebas de fallo de red.
Negociación con proveedores: consejos prácticos
- Exigir SLA claros para latencia, disponibilidad y soporte on-site.
- Negociar precios por piloto y escalado (descuentos por volumen).
- Solicitar cláusulas de soberanía de datos y certificaciones de seguridad.
- Incluir cláusulas para pruebas de rendimiento y penalidades por no cumplimiento.
- Valorar partners locales para soporte físico y cumplimiento regional.
Conclusion
Una estrategia híbrida de IA es, en LATAM, una respuesta práctica a latencia, costos y regulación. Empieza con un diagnóstico claro, prueba en un piloto y despliega por fases, priorizando inferencia y datos sensibles. Usa la checklist y el roadmap aquí presentados para reducir riesgos y negociar con proveedores desde una posición informada. Si quieres, podemos ayudarte a diseñar el diagnóstico inicial o revisar tu cálculo de TCO para tomar la decisión correcta: actúa ahora y convierte la incertidumbre en ventaja competitiva.
¿Quieres aplicar esto en tu negocio? Escríbeme y lo vemos juntos.
Hablemos de tu caso