Estrategia práctica para desplegar IA híbrida en empresas LATAM entre nube y on-prem
Introduccion
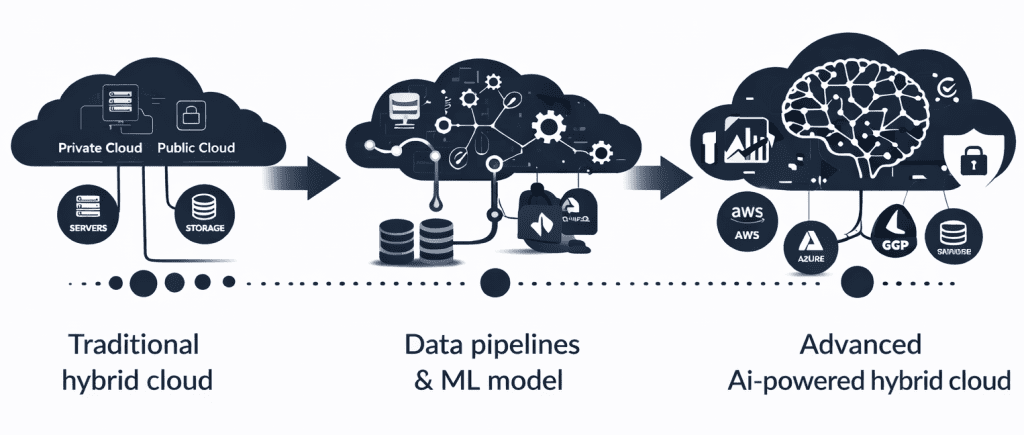
Las empresas LATAM enfrentan una tensión práctica al desplegar aplicaciones de IA: la nube pública ofrece escalabilidad y servicios gestionados, mientras que las sedes on‑prem y el edge garantizan cumplimiento, baja latencia y control sobre datos sensibles. Esta guía explica cómo evaluar casos de uso, comparar opciones de hardware y proveedores, y seguir un plan paso a paso para una adopción híbrida rentable y segura.
Evaluación de casos de uso y criterios de decisión
Antes de elegir tecnología, prioriza según impacto y restricciones. Preguntas clave:
- ¿Requiere latencia sub‑100 ms (control industrial, detección en tiempo real)?
- ¿Existen requisitos de soberanía o regulaciones locales sobre datos?
- ¿Volumen y variabilidad de inferencias/entrenamiento?
- ¿Capacidad interna para operar infraestructura on‑prem?
Criterios para priorizar:
- Latencia crítica → mover al edge/on‑prem.
- Datos sensibles o regulados → on‑prem o región específica.
- Picos impredecibles de demanda → nube pública.
- Coste por inferencia y TCO → comparar TCO total (capex + opex).
Casos típicos en LATAM:
- Retail y vigilancia: modelos en el borde para procesamiento de video.
- Banca y salud: on‑prem con replicación a nube para análisis agregado.
- Agricultura y manufactura: edge para sensores + nube para modelos globales.
Comparativa técnica: hardware y proveedores
Hardware
- CPUs empresariales (Intel Xeon, AMD EPYC): adecuados para preprocesado, tareas batch y cargas ligeras de inferencia.
- GPUs (NVIDIA A100/H100, AMD MI300): necesarias para entrenamiento y modelos grandes; alto rendimiento pero mayor coste operativo y consumo.
- Aceleradores para inferencia (NVIDIA Triton en Jetson/Xavier, AWS Inferentia, Google TPU/Edge TPU): diseñados para baja latencia y eficiencia energética en producción.
- Edge devices: NVIDIA Jetson, Google Coral y soluciones de terceros permiten despliegues distribuidos con consumo moderado.
Proveedores y servicios gestionados
- AWS: SageMaker para entrenamiento y endpoints gestionados; Inferentia para inferencia optimizada. https://aws.amazon.com
- Google Cloud: Vertex AI para ciclo completo de ML, TPUs para entrenamiento. https://cloud.google.com
- Azure: Azure ML y servicios de IoT para edge y orquestación. https://azure.microsoft.com Consideraciones: interoperabilidad (contenerización con Docker/Kubernetes), soporte local, ecosistema de partners y latencia a centros de datos.
Marco paso a paso para decidir arquitectura y calcular costes
- Mapear datos y requisitos: inventario de fuentes, regulaciones y niveles de sensibilidad.
- Clasificar workloads: entrenamiento vs inferencia; tiempo real vs batch.
- Diseñar topología híbrida: decidir qué se queda on‑prem/edge y qué se mueve a la nube.
- Seleccionar hardware y proveedor:
- Prueba pilotos con instancias equivalentes en nube y on‑prem.
- Considera aceleradores dedicados para cargas de alta demanda.
- Calcular TCO y coste por inferencia:
- Componentes: capex (HW + instalación), opex (electricidad, refrigeración, personal), licencias, red, almacenamiento, coste nube (instancias + almacenamiento + egress).
- Regla práctica: coste_por_inferencia ≈ (coste_hora_compute / inferences_hora) + network_media_por_inferencia + almacenamiento_por_inferencia.
- Usa calculadoras oficiales para estimación: AWS Pricing Calculator, Google Cloud Pricing Calculator, Azure Pricing Calculator:
- Piloto y validación operativa: medir latencia real, coste por transacción y carga operativa.
- Despliegue incremental y gobernanza: políticas de acceso, cifrado, monitoreo de modelos y pipelines CI/CD de ML.
Operación, seguridad y monitoreo
- Data governance: cifrado en tránsito y reposo, separación de entornos, registro de accesos.
- Observabilidad: métricas de latencia, tasa de error, deriva de modelos y consumo de recursos.
- Actualizaciones: pipeline para redeploy y rollback; pruebas A/B para nuevos modelos.
- Formación interna: capacitar equipos de TI y Data Science en operación híbrida y en herramientas de orquestación (Kubernetes, KubeEdge, MLflow).
Conclusion
Una estrategia híbrida bien diseñada permite a empresas latinoamericanas equilibrar rendimiento, cumplimiento y coste. Comienza por mapear casos de uso críticos, realiza pilotos comparativos y calcula TCO con cuidado antes de escalar. Invita a tu equipo a definir un primer piloto de 3 meses que pruebe latencia, coste por inferencia y gobernanza; eso dará datos reales para decidir la mezcla óptima entre nube, on‑prem y edge. Si quieres, comparte tu caso y te orientamos sobre el piloto más adecuado para tu industria.
¿Quieres aplicar esto en tu negocio? Escríbeme y lo vemos juntos.
Hablemos de tu caso